Thanos at scale : archi, perf et FinOps
Écrit pour Thanos 0.42
Les flags et leurs valeurs par défaut bougent d'une version à l'autre et certains sont dépréciés en silence, comme --store.grpc.series-sample-limit remplacé par --store.limits.request-samples. Vérifier contre la doc de sa propre version avant de copier quoi que ce soit et ne rien lire ici comme un optimum : ce sont les arbitrages qu'on a faits avec nos contraintes, pas une configuration de référence.
Un Prometheus garde ses métriques aussi longtemps qu'on le lui demande. On pose --storage.tsdb.retention.time ou --storage.tsdb.retention.size si on préfère plafonner en volume et c'est réglé. La rétention n'a jamais été le problème.
Le problème est ailleurs. La TSDB vit sur un seul disque sans réplication et elle grossit linéairement parce que Prometheus ne downsample pas. Surtout, elle ne sait répondre que pour elle-même alors qu'avec une vingtaine de clusters on veut une requête qui les traverse toutes.
C'est pour ça qu'on met Thanos devant. La doc explique très bien les mécanismes, mais personne n'écrit la facture, ni le fait que chaque décision est un arbitrage où on gagne sur le coût pour payer ailleurs. Certaines de ces décisions, on a dû les annuler.
Thanos, Mimir ou VictoriaMetrics
Premier malentendu à lever. On associe souvent Thanos au mode sidecar, donc à du pull, par opposition à Mimir qui serait du push. C'est faux dès qu'on utilise Thanos Receive : les Prometheus font un remote_write, exactement comme vers Mimir. Le chemin d'ingestion est le même, la config Alloy aussi (voir Grafana Alloy, il suffit de changer l'URL).
Et le mode Receive apporte quelque chose que le sidecar ne peut pas donner : le filtrage à la source. Le sidecar uploade les blocks de la TSDB telle qu'elle est, donc tout ce qui est scrapé finit dans le bucket. Le seul filtre disponible est metric_relabel_configs, au scrape, qui supprime la métrique localement aussi. Avec remote_write on utilise write_relabel_configs, qui ne touche que ce qui part.
remote_write:
  - url: http://thanos-receive:19291/api/v1/receive
    write_relabel_configs:
      # tout ce qui est utile en debug local mais pas sur 14 mois
      - source_labels: [__name__]
        regex: 'go_.*|process_.*|promhttp_.*'
        action: drop
      # les histogrammes de latence par endpoint, ingérables en cardinalité
      - source_labels: [__name__, handler]
        regex: 'http_request_duration_seconds_bucket;/api/v1/.*'
        action: drop
C'est le levier de coût le plus direct de toute la stack, parce qu'il agit avant l'ingestion : on ne paye ni le stockage, ni la compaction, ni la cardinalité de ce qu'on a laissé sur place. La rétention locale de Prometheus reste complète pour du debug à chaud, seule la longue traîne est filtrée.
Le vrai critère de choix est ailleurs : une stack isolée par tenant ou un cluster mutualisé ?
- Mimir et VictoriaMetrics poussent vers un backend unique et multi-tenant, avec des limites par tenant
- Thanos Receive permet le multi-tenant, mais rien n'oblige à l'utiliser ainsi
On a pris le chemin inverse du manuel : un jeu complet de composants par cluster source. Chaque cluster a son bucket, son namespace, son receive, ses store gateways, son querier. Ça multiplie les composants et c'est assumé.
Ce qu'on y gagne :
- le blast radius d'un tenant en surcharge s'arrête à son namespace
- le dimensionnement se fait par tenant, un petit cluster ne paye pas pour le gros
- pas de bruit de voisinage sur l'ingestion
Ce qu'on y perd : une vingtaine de compactors, de queriers et de store gateways à opérer. C'est tout le sujet de la suite.
L'architecture high-level
Une stack complète par tenant et au-dessus un querier global qui fait le fan-out sur tous les queriers régionaux.

Ce querier global pousse la parallélisation bien plus haut que les régionaux, avec son propre cache de résultats. Rien n'oblige à n'en avoir qu'un. On peut poser un second querier global sur un sous-ensemble de tenants, pour donner à une équipe une vue limitée à son périmètre sans lui ouvrir la flotte entière.
query:
  extraFlags:
    - --query.auto-downsampling
    - --grpc-compression=snappy
queryFrontend:
  extraFlags:
    - --query-range.split-interval=12h
    - --labels.max-query-parallelism=256      # 50 en régional, 14 par défaut
    - --query-range.max-query-parallelism=256
    - --query-frontend.compress-responses
    - --cache-compression-type=snappy
    - --query-frontend.log-queries-longer-than=10s
Ce qui compte n'est pas dans les flags, c'est que la liste des stores à interroger est dérivée du même sélecteur de labels que le générateur des stacks, pas écrite en dur. Une liste statique dérive toujours. On finit avec une entrée qui pointe vers un Thanos mort ou un tenant que personne n'interroge.
--query-frontend.log-queries-longer-than=10s est à activer dès le premier jour. C'est ce qui permet de savoir quel dashboard fait souffrir la stack, plutôt que de le deviner.
Mais attention à ce qu'on y lira. Le querier global attend toutes les stacks avant de répondre, donc la latence perçue est celle de la branche la plus lente. Une stack qui répond en 150 ms au p99 mais en 4 s dans sa queue suffit à produire des requêtes utilisateur à 25 s, dès lors que le fan-out en interroge une vingtaine : la probabilité de tomber sur au moins un traînard devient forte.
On a chassé longtemps des requêtes coûteuses avant de comprendre que les plus lentes étaient triviales. Un sélecteur sur 9 séries qui met 26 secondes ne coûte rien à calculer, il attend. Le levier n'est alors ni le cache ni le sizing : c'est de réduire le fan-out, en s'assurant que les external labels annoncés par chaque stack permettent au querier global d'élaguer ceux qui ne peuvent pas matcher, ou de borner la queue avec le couple --store.response-timeout et --query.partial-response.
Partial response et alerting ne font pas bon ménage
Si les principaux appelants sont des règles d'alerte - et c'est souvent le cas, elles tournent en continu là où un dashboard n'est ouvert que par intermittence - une réponse incomplète peut sous-rapporter silencieusement et ne pas déclencher. Borner la latence au prix d'une alerte qui rate n'est pas un bon échange.
Et il y a un effet de bord qu'on ne voit pas venir : une réponse partielle n'est jamais cachée. Le query frontend refuse de cacher les réponses partielles comme celles assorties d'un warning, ce qui veut dire qu'on perd le cache précisément au moment où il servirait le plus. Les requêtes passent en partiel, donc deviennent non cachables, donc chaque rafraîchissement repart de zéro sur une infrastructure déjà en souffrance. C'est un amplificateur, pas un amortisseur.
Le flag ne fixe qu'un défaut et les clients peuvent le surcharger par requête avec le paramètre partial_response. La voie médiane est donc de laisser le défaut désactivé, ce qui protège les règles d'alerte et le cache et de l'activer uniquement sur la datasource Grafana des humains, où une réponse partielle assortie d'un warning vaut mieux qu'un spinner de 25 secondes.
Annoncer le label sur lequel on filtre
Le querier global n'écarte une stack que si les matchers de la requête contredisent un label que cette stack annonce. Pas un label présent dans ses séries, un label présent dans son info endpoint : la nuance décide de tout et on a mis longtemps à la voir.
Nos queriers de tenant annonçaient leurs labels de receive, qui identifient bien la stack mais que personne n'écrit jamais dans une requête. Les dashboards, eux, filtrent sur le nom du cluster. Aucun matcher ne pouvait donc contredire quoi que ce soit, aucune branche n'était élaguable et chaque requête partait sur la vingtaine de stacks.
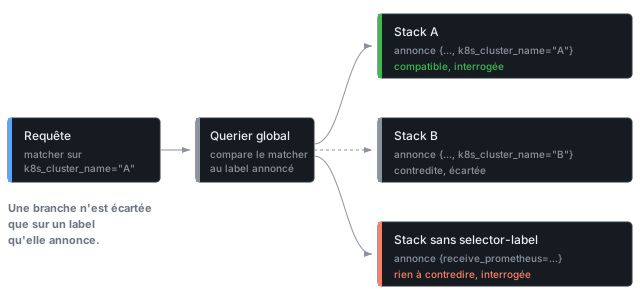
Ça se lit sans rien instrumenter : toutes les stacks servaient le même débit d'appels Series à 0,4 % près. Un tenant qui pèse quelques dizaines de milliers de séries encaissait exactement le même nombre d'appels que le plus gros de la flotte.
Reste à choisir quel label annoncer. Le choix se contraint tout seul, parce que 2 conditions pèsent en même temps : le label doit être celui que les requêtes portent réellement, sinon aucun matcher ne le contredira jamais et l'annonce ne sert à rien, et il ne doit avoir qu'une seule valeur par stack, sinon la stack se retirera des requêtes qui cherchent ses autres valeurs. Les 2 ensemble ne laissent en général qu'un candidat.
Chez nous c'est le label de cluster que les Prometheus posent en external label et sur lequel toutes les variables de dashboard sont câblées, k8s_cluster_name de son petit nom. Il n'a rien de standard, c'est une convention interne : ce qui compte est qu'il coche les 2 cases, pas comment il s'appelle.
Le flag se pose ensuite sur le querier de chaque tenant :
Il se vérifie dans l'info endpoint et pas dans la conf, le label doit apparaître dans les external_labels que le querier global expose sur thanos_store_nodes_grpc_connections.
ProxyStore.LabelSet() passe par ExtendSortedLabels, donc le flag étend les label sets remontés des stores en aval au lieu de les remplacer : tout ce qui filtrait déjà sur les autres labels continue de marcher.
Une stack qui ingère 2 clusters ne peut pas être annotée
La seconde condition n'est pas théorique : 4 de nos stacks reçoivent 2 clusters chacun, parce que des clusters sans bucket dédié poussent dans le receiver régional. --selector-label ne portant qu'une valeur par clé et ProxyStore.Series() s'auto-filtrant dessus, une valeur unique n'y ralentit pas la requête, elle renvoie vide pour le second cluster. C'est une perte de données silencieuse en lecture, donc le flag se pose en opt-in par stack et jamais en défaut de template.
Le gain réel a été de 28 % d'appels en moins sur les stacks annotées, pas les 96 % qu'on visait. L'écart vaut pour toute flotte multi-tenant.
Une stack qu'on n'a pas pu annoter reste interrogée par 100 % des requêtes, donc même une requête parfaitement scopée sur un cluster touche encore tous ceux-là. Et surtout la plupart des requêtes ne portent aucun filtre de cluster : en passant en revue les 1300 dashboards de notre Grafana, sur les 417 qui interrogent le store global, 71 ont une variable de cluster et 346 n'en ont aucune. Une variable laissée sur « All » ne compte pas davantage, elle se rend en regex qui matche tout.
Ce n'est pas de la négligence. Un développeur qui regarde son API ne sait pas, et n'a pas à savoir, sur quel cluster tourne son pod : sa requête filtre sur un job ou un namespace et aucun label ne permet de l'élaguer. Le fan-out est réductible pour les dashboards d'infra qui savent où ils regardent, irréductible pour tout le reste.
La charge de fan-out d'un tenant ne dit rien de sa taille, elle suit le workload de requêtes. Sur 24h les stacks montent et descendent ensemble, de 17,7 à 45,1 appels par seconde selon l'heure, tous à quelques pourcents les uns des autres. Dimensionner une stack sur sa volumétrie ignore donc la moitié de ce qui la sollicite.
Le chemin d'une métrique

La couleur porte l'essentiel : tout ce qui est stateless et rejouable tourne sur spot, seul le chemin d'ingestion reste on-demand.
Éviter le trafic inter-zone
Chaque flèche du schéma précédent est du trafic facturé. Receive qui uploade ses blocks, la store gateway qui les retélécharge à chaque miss de cache, les séries qui remontent en gRPC vers le querier, puis le fan-out du querier global sur tous les régionaux. À une vingtaine de tenants le volume est conséquent et personne ne le regarde parce qu'il n'apparaît pas sur la ligne compute.
Sur GCP, un transfert entre 2 zones d'une même région est facturé, alors qu'il est gratuit à l'intérieur d'une zone. On colle donc tous les composants d'une stack dans la même zone, au lieu de laisser le scheduler les répartir pour faire de la haute dispo.
Le bucket suit la même logique mais à la maille région, un bucket GCS étant régional et pas zonal. Depuis une VM de la même région la sortie ne coûte rien, alors qu'un bucket dans une autre région ou en multi-région se paye à chaque lecture et la store gateway lit beaucoup.
Le prix : plus de redondance de zone
Une stack dans une seule zone tombe avec sa zone. C'est le même arbitrage que le RF=1 : on accepte de perdre un tenant le temps d'une panne zonale plutôt que de payer du trafic inter-zone en permanence. Sur des métriques la perte est bornée et l'historique reste dans le bucket, ce qui rend le compromis tenable là où il ne le serait pas sur une base transactionnelle.
C'est aussi ce qui rend le cache partagé et --grpc-compression=snappy rentables au-delà de la latence : ils réduisent des octets qui sont facturés. Attention à ce flag, il porte un Deprecated after v0.43.0 dans son aide, la compression se configurant désormais par endpoint dans la service discovery fichier.
La version de Thanos compte autant que la config. Le batching gRPC arrivé en 0.41 groupe jusqu'à 64 séries par message SeriesResponse au lieu d'une, ce qui amortit l'overhead par message. Les auteurs annoncent des économies réseau importantes et des queriers qui consomment un peu moins de CPU. Le 64 est la taille de lot par défaut (DefaultResponseBatchSize), pas un facteur de gain, et le flag query.series-response-batch-size qui permettait de la régler a disparu quand le batching est passé actif par défaut. Aucun tuning de config ne donne ça.
Spot pour tout ce qui se rejoue
Un pod de querier évicté n'est pas important, la requête sera réessayée sur un autre pod. Une store gateway évictée retélécharge ses index-headers. Un compactor évicté reprendra son travail au run suivant. Tous ces composants sont sur un node pool spot dédié.
Receive, non. C'est le seul composant qui tient de la donnée pas encore uploadée. Il reste sur un pool on-demand, avec un priorityClassName dédié pour ne pas se faire évicter par la pression d'un autre workload.
# Composants rejouables
tolerations:
  - key: kubernetes.io/arch
    value: arm64
    effect: NoSchedule
nodeSelector:
  cloud.google.com/compute-class: thanos-spot

---
# Receive : chemin d'ingestion stateful
nodeSelector:
  cloud.google.com/compute-class: thanos
priorityClassName: thanos-receive-critical
Le prix à payer se voit à la reprise. Une store gateway peut mettre jusqu'à 30 minutes à redevenir prête après une éviction, le temps de retélécharger ses index-headers. Il faut caler les alertes dessus, sinon on se réveille la nuit pour rien.
- alert: ThanosStoreIsDown
  expr: up{job=~".*thanos-store.*"} == 0
  for: 30m      # et pas 5m : la reprise après éviction spot est lente
partial-response seul ne coupe aucune branche lente
--store.response-timeout vaut 0ms par défaut, ce qui désactive le timeout. Tant qu'on n'y touche pas, une store gateway lente mais vivante est attendue jusqu'à --query.timeout, et la réponse partielle ne sauve que le cas d'un store réellement injoignable. La doc est explicite : if you prefer availability over accuracy you can set tighter timeout to underlying StoreAPI than overall query timeout. C'est le couple des 2 flags qui borne la latence, pas partial-response tout seul.
Reste une question qu'on oublie de se poser : pendant ces 30 minutes, que voit l'utilisateur ? Ça dépend de --query.partial-response, activé par défaut. La query renvoie ce qu'elle a pu récupérer, assorti d'un warning, plutôt qu'une erreur. Un dashboard affiche donc un graphe avec un trou dedans et le trou ne se voit pas forcément.
C'est le bon comportement pour du dashboard temps réel, beaucoup moins pour une règle d'alerting ou un rapport de capacité. Le paramètre se surcharge par requête et une réponse partielle n'est jamais mise en cache.
Le tout tourne sur des instances ARM, ce qui se cumule avec le spot sur le ratio prix/performance. La tolération arch=arm64 est posée sur tous les composants.
Receive : le composant le plus cher
Receive garde la head de sa TSDB en mémoire, donc sa consommation ne suit pas le débit d'ingestion mais le nombre de séries actives. Doubler la fréquence de scrape ne change presque rien, ajouter un label à forte cardinalité fait exploser la facture et comme c'est le seul composant en on-demand chaque Gio y coûte plus cher qu'ailleurs.
On ne plafonne pas cette RAM, on agit sur ce qui la fait grossir.
Le levier le moins cher reste de réduire le nombre de séries. Le write_relabel_configs vu plus haut agit avant l'ingestion donc il ne coûte rien et le head_series_limit par tenant plafonne ensuite ce qu'un cluster peut pousser.
Vient ensuite le sharding du hashring. hashmod répartit déjà les séries sur tous les receivers, ce que Ketama apporte c'est la stabilité quand le pool bouge : la doc le présente comme a consistent hashing scheme which enables stable scaling of Receivers without the drawbacks of the hashmod algorithm. Avec hashmod, ajouter un pod redistribue une grande partie des séries et provoque un pic mémoire sur tout le monde. C'est le nombre de pods qui fait baisser la RAM par pod, Ketama est ce qui permet de changer ce nombre sans douleur.
Le plus structurant est de séparer le routing de l'ingestion. Quand --receive.local-endpoint n'est pas défini, un Receive tourne en mode routeur pur et transmet les écritures sans rien stocker localement. On peut alors poser beaucoup de routeurs légers devant peu d'ingesters et ne payer de la RAM que sur ces derniers.
Ce qu'on n'active pas sans raison
Les caches de postings étendus (--tsdb.head.expanded-postings-cache-size et son équivalent block) sont expérimentaux et désactivés par défaut : les activer se paye directement en mémoire. Les exemplars aussi, --tsdb.max-exemplars valant 0, ce qui veut dire au passage que les exemplars envoyés en remote_write sont droppés en silence.
Le redémarrage est le moment dangereux
Au redémarrage, Receive rejoue son WAL en mémoire avant d'accepter du trafic. Si le pod OOM avant la fin, le WAL a grossi entre-temps et le replay suivant est plus lourd encore, ce qui transforme un simple restart en indisponibilité longue. Le signal à surveiller est le nombre de segments WAL et pas up : une croissance continue veut dire que la compaction ne suit plus.
Enfin, comme Receive est un binaire Go, il mérite un GOMEMLIMIT calé sur sa limite de pod. Sans ça le GC laisse la heap grossir jusqu'à l'OOM kill au lieu de s'emballer pour rester sous le seuil. Voir GOMAXPROCS et GOMEMLIMIT dans Kubernetes.
Rétention et downsampling

3 paliers sur le compactor :
430 jours plutôt que 365, parce que comparer un pic saisonnier à celui de l'année d'avant demande un peu de marge et 2 mois de plus ne coûtent presque rien à cette résolution.
Et c'est là que le downsampling devient intéressant : la longue traîne est quasi gratuite. Passer de 15 secondes à 1 heure, c'est 240 fois moins de points. Les 430 jours en résolution horaire pèsent une fraction des 45 jours en résolution native. Garder un an ne coûte pas 12 fois 2 mois.
Ne jamais gérer les blocks avec une lifecycle policy du bucket
Le compactor est le seul composant qui connaît les dépendances entre un block raw et ses versions downsamplées, donc lui seul peut décider quoi supprimer. Une politique de cycle de vie côté object storage supprime ou archive à l'aveugle.
Le retour d'expérience d'Anuj Ramola est instructif. Son équipe a basculé 6 mois de blocks vers Glacier Deep Archive pour économiser une cinquantaine de dollars mensuels de stockage. Le compactor a voulu compacter des blocks devenus illisibles sans restauration préalable, a échoué et a retenté toutes les 5 minutes en boucle. Les requêtes objet sont passées de 1,1 million à 40 millions par jour, soit 13 dollars à 480 dollars sur la seule ligne API et l'économie de stockage a été payée 10 fois.
Dans le même ordre d'idées, les paliers du compactor doivent rester alignés sur ce que les store gateways servent réellement, sinon on paye pour des blocks que personne n'interroge ou on cherche de la donnée que la rétention a déjà supprimée.
Côté flags de compaction :
extraFlags:
  - --deduplication.func=penalty
  - --deduplication.replica-label=prom_replica
  - --compact.enable-vertical-compaction
  - --block-files-concurrency=2
  - --compact.blocks-fetch-concurrency=1
  - --downsample.concurrency=1
  - --no-debug.halt-on-error
Un mot sur --no-debug.halt-on-error : le compactor sort en erreur au lieu de continuer en silence. On préfère un job rouge à un bucket qui se dégrade sans que personne ne le voie.
Ce garde-fou a une limite qu'il faut connaître. Le downsampling peut se terminer sur un warning du type empty chunks happened, skip series sans jamais passer en erreur, donc sans halte et la rétention supprimera ensuite les blocks raw alors qu'aucun remplaçant downsamplé n'a été produit. Le halt ne couvre que les vraies erreurs, pas les succès assortis d'un warning, ce qui oblige à surveiller les logs du compactor et pas seulement ses codes de sortie.
Les 3 flags de concurrence sont à 1 ou 2 volontairement. Ils valent 1 par défaut et la doc recommande d'allouer un cœur CPU par unité de --compact.concurrency. Les monter transforme un job court en job cher.
2 flags à ne pas activer à l'aveugle
--deduplication.func=penalty sert à dédupliquer des replicas Prometheus qui ne sont pas bit à bit identiques, mais l'algorithme casse encore occasionnellement les rate et irate. Quant à --compact.enable-vertical-compaction, il fusionne des flux de blocks : si 2 producteurs différents publient avec les mêmes external labels, leurs séries se mélangent et deviennent inexploitables. C'est pour ça que chaque tenant a son propre jeu d'external labels et c'est non négociable.
Compacter sans payer le disque 24h/24
C'est l'optimisation la plus rentable de la stack et celle qui a le plus d'effets de bord.
Un compactor déployé en Deployment tourne 24h/24 avec son PVC attaché en permanence. Sauf qu'il ne travaille réellement que quelques minutes toutes les quelques heures. Sur une vingtaine de stacks, ça fait une vingtaine de disques facturés en continu pour un usage marginal.
On l'a donc passé en CronJob avec un volume éphémère :
compactor:
  enabled: false        # on ne veut pas le Deployment du chart

# CronJob maison
schedule: "0 */6 * * *"
concurrencyPolicy: Forbid
successfulJobsHistoryLimit: 1
failedJobsHistoryLimit: 1
ttlSecondsAfterFinished: 600
persistence:
  ephemeral: true
  storageClass: hyperdisk-balanced
Le concurrencyPolicy: Forbid n'est pas cosmétique. 2 compactors simultanés sur le même bucket corrompent les blocks. C'est une garantie que le Deployment assurait tout seul et qu'il faut réclamer explicitement en CronJob.
Le volume éphémère est ce qui matérialise l'économie. Le disque est créé avec le Pod et réclamé à la fin du job. Plus de PVC en Bound entre 2 runs.
L'effet de bord : l'alerting ment
La règle standard ThanosCompactIsDown repose sur un absent() ou un up == 0. Entre 2 runs, il n'y a plus ni Pod, ni Service, ni cible de scrape. La règle passe donc en alerte en permanence, 23 heures sur 24.
Il faut la neutraliser et la remplacer par des règles qui interrogent l'état du CronJob via kube-state-metrics :
# La règle générique ne peut pas matcher
- alert: ThanosCompactIsDown
  expr: vector(0) == 1

# Aucun run réussi depuis 12h, alors que le schedule est à 6h
- alert: ThanosCompactCronJobStale
  expr: |
    time() - kube_cronjob_status_last_successful_time{cronjob=~".*thanos-compact.*"} > 12 * 3600
  for: 30m

# Un job en échec
- alert: ThanosCompactCronJobFailed
  expr: kube_job_failed{job_name=~".*thanos-compact.*"} > 0
  for: 5m
La fenêtre de 12 heures tolère un cycle manqué. ThanosCompactCronJobFailed reste du best-effort. Le ttlSecondsAfterFinished à 600 fait disparaître le Job 10 minutes après son échec, donc la fenêtre de détection est courte.
Ces 2 règles disent si le job tourne, pas s'il fait son travail. Un compactor peut réussir tous ses runs et laisser le backlog s'accumuler parce que la concurrency ne suit pas le volume produit. Le bucket grossit alors en continu sans que rien ne s'allume.
Depuis la v0.24 le compactor expose 4 gauges faites pour ça, thanos_compact_todo_compactions, thanos_compact_todo_compaction_blocks, thanos_compact_todo_downsample_blocks et thanos_compact_todo_deletion_blocks. Sauf qu'elles ne servent à rien ici.
Les gauges de backlog n'existent pas en CronJob
Les 3 calculateurs de progression qui les alimentent sont enfermés dans un if conf.wait de cmd/thanos/compact.go, et l'aide de --compact.progress-interval le dit noir sur blanc : when --wait has been enabled. Un compactor en CronJob tourne sans --wait, donc il n'enregistre jamais ces gauges. Une alerte posée dessus ne se déclenche pas, ce qui est pire qu'une alerte absente. Même piège avec --wait-interval, qui ne sert à rien sans --wait : c'est pour ça qu'il ne figure pas dans les extraFlags plus haut.
On ne récupère pas ces gauges sans revenir au Deployment, donc sans rendre le disque à la facturation. Le compromis qu'on a retenu est de lire le backlog du côté des store gateways, qui tournent en continu et resynchronisent les métadonnées de blocks toutes les 15 minutes.
# Le nombre de blocks du bucket ne redescend plus sur 24h
- alert: ThanosCompactBacklog
  expr: |
    min(thanos_blocks_meta_synced{state="loaded", job=~".*thanos-store.*"})
      - min(thanos_blocks_meta_synced{state="loaded", job=~".*thanos-store.*"} offset 24h)
      > 0
  for: 24h

# Des compactions échouent, tous groupes confondus
- alert: ThanosCompactGroupFailures
  expr: sum(increase(thanos_compact_group_compactions_failures_total[24h])) > 0
  for: 5m
C'est un proxy, pas le compte exact des compactions en attente : un bucket dont le nombre de blocks ne redescend jamais est un bucket que le compactor ne rattrape pas. thanos_compact_group_compactions_failures_total porte un label resolution et pas group, donc on ne peut pas isoler le groupe qui traîne, seulement la résolution.
Un shard par timerange
Une store gateway qui sert tout le bucket doit être dimensionnée pour la requête la plus violente qu'on lui posera jamais, par exemple un dashboard avec un timerange de 6 mois qui va charger énormément de donnée en RAM sur tous les replicas, pendant que le dashboard temps réel attend derrière.
Or les 2 profils d'accès n'ont rien à voir :
- les données récentes sont interrogées en permanence, sur un petit volume et doivent répondre vite
- les données anciennes sont interrogées rarement, mais chaque requête scanne énormément et supporte d'être lente
On a donc découpé la store gateway en 3 shards par timerange, avec 2 replicas chacun. Le plus récent démarre à 3 heures, parce qu'en dessous c'est Receive qui sert encore la donnée depuis sa TSDB.

Les 2 flags sont négatifs et se lisent à l'envers de ce qu'on croit. --min-time est la borne la plus ancienne, donc le nombre le plus grand en valeur absolue. --max-time est la plus récente.
# shard 0 : de 3h à 1 jour, le chaud, sollicité en continu
- --min-time=-26h
  --max-time=-3h

# shard 1 : de 1 jour à 1 semaine
- --min-time=-8d
  --max-time=-23h

# shard 2 : tout ce qui est plus vieux qu'une semaine
- --max-time=-6d
Le découpage sert 2 choses.
Le dimensionnement suit le profil d'accès. Chaque shard est taillé pour son usage, donc sur les gros tenants le shard historique monte à plusieurs dizaines de Gio de RAM sans qu'on les donne aux 2 autres, alors que le shard chaud reste modeste. Sans découpage on paye le pire cas partout.
Le blast radius se réduit aussi, puisqu'une requête de 6 mois ne tape que le shard historique. Elle peut le saturer sans mettre par terre celui qui sert le dernier jour.
Faire chevaucher les plages, volontairement
Les bornes ci-dessus se recouvrent d'une heure ou d'un jour et ce n'est pas une erreur. La doc Thanos recommande explicitement le chevauchement : le querier sait fusionner et ça évite un trou si un shard est indisponible. À l'inverse, des bornes jointives au millimètre garantissent une fenêtre aveugle dès qu'un replica manque.
Le filtrage se fait au niveau du chunk et pas de l'échantillon, donc un shard peut renvoyer des points hors de sa plage annoncée. La découverte des blocks est aussi asynchrone, à l'intervalle de --sync-block-duration qui vaut 15 minutes par défaut, ce qui s'ajoute au délai d'upload.
Ce découpage temporel n'est pas le seul possible. Quand c'est le bucket d'un seul tenant qui devient trop gros, le sharding par labels externes via --selector.relabel-config répond mieux et les 2 se combinent.
Payer de la capacité disque pour acheter du débit
La store gateway tournait au départ sur emptyDir, donc sur le disque de boot du nœud. Sur les gabarits qu'on avait choisis, le téléchargement des index-headers au démarrage saturait ce disque : les instances sont IO bound et un store qui doit rapatrier ses index-headers y passe un temps déraisonnable. Ce sont ces mêmes minutes qu'on retrouve dans les 30 minutes de reprise après éviction.
D'où un PVC dédié pour la store gateway, dimensionné pour le débit et non pour la place.
Sur Hyperdisk Balanced, la performance est découplée de la capacité, et c'est le piège quand on arrive du Persistent Disk. Les IOPS et le débit se provisionnent explicitement, les 3000 premières IOPS et 140 Mio/s sont offerts, le reste est facturé. La capacité ne fait que relever le plafond de ce qu'on a le droit de provisionner, MIN(500 x Gio, 160000), ce qui impose au minimum 6 Gio pour avoir droit aux 3000 IOPS de base.
Grossir le disque sans toucher au reste ne donne donc presque rien : sans provisioned-iops-on-create, le défaut suit 6x + 3000, et passer de 6 à 20 Gio fait passer de 3036 à 3120 IOPS, soit 3 % de mieux. Le volume d'index-header est à 20 Gio pour débloquer le plafond, mais ce sont les IOPS provisionnées dans la StorageClass qui coûtent et qui font le travail.
C'est un contournement, pas une optimisation
Tout ce calcul existe parce qu'on a choisi des instances économiques qui sont IO bound. Avec des gabarits plus généreux en débit disque ou du local SSD, le problème ne se poserait pas et la store gateway n'aurait pas besoin de PVC du tout. On a déplacé le coût du compute vers le stockage, ce qui reste gagnant sur la facture, mais il faut savoir que la solution propre est ailleurs.
Mutualiser les caches
Thanos a 3 caches, tous en mémoire du process par défaut, ce qui donne une centaine de caches froids sur la flotte et fait payer chaque éviction spot deux fois. Le sujet a sa propre page : Les caches Thanos couvre la mutualisation sur un backend partagé, ce que le caching bucket ne sait pas partager entre tenants, le dimensionnement et le gain côté facture.
Mettre des limites en lecture et en ingestion
Logger les requêtes lentes ne suffit pas, il faut pouvoir les arrêter. Avec RF=1 et des store gateways sur spot, un seul dashboard qui balaie plusieurs mois de raw peut saturer une store qui mettra ensuite ses 30 minutes à revenir.
Côté lecture, les garde-fous sont sur la store gateway :
extraFlags:
  - --store.limits.request-series=2000000
  - --store.limits.request-samples=100000000
  - --store.grpc.downloaded-bytes-limit=10GB
  - --store.grpc.series-max-concurrency=20
Les 2 premiers remplacent --store.grpc.touched-series-limit et --store.grpc.series-sample-limit, qui sont dépréciés. Les 3 limites valent 0 par défaut, c'est-à-dire aucune limite. --store.grpc.series-max-concurrency est l'exception : il vaut déjà 20, donc la ligne ci-dessus ne change rien et sert surtout à rendre la valeur visible dans le manifest.
Côté ingestion c'est plus intéressant financièrement, parce que Receive est on-demand donc le plus cher au vCPU et que rien ne le protège d'un tenant qui explose en cardinalité.
# --receive.limits-config-file
write:
  default:
    request:
      size_bytes_limit: 0
      series_limit: 1000
      samples_limit: 10000
    head_series_limit: 1000000
  tenants:
    gros-tenant:
      head_series_limit: 5000000
head_series_limit n'est pas une barrière étanche
Il a besoin d'une meta-monitoring, c'est-à-dire d'un endpoint compatible Prometheus Query API que Receive interroge toutes les 15 secondes pour connaître le nombre de séries actives par tenant. Si cet endpoint est injoignable, Receive arrête de limiter et se contente de logger. La donnée étant par nature en retard, on dépasse toujours un peu la limite et la fonctionnalité est marquée expérimentale.
Les 2 familles de limites ne rendent pas le même code et la nuance décide de qui perd de la donnée. Les limites de requête (series_limit, samples_limit, size_bytes_limit) rendent un 413, que Prometheus ne rejoue pas : ce qui est refusé est perdu, et une limite trop basse fait des trous dans les métriques du tenant. Le head_series_limit, lui, rend un 429 (tenant is above active series limit), que Prometheus rejoue selon son retry_on_http_429. Poser une limite de séries actives ralentit donc un tenant, poser une limite de requête l'ampute.
GOMAXPROCS : le parallélisme qu'on n'a pas choisi
Le moteur PromQL de Thanos découpe chaque sélecteur de vecteur en plusieurs goroutines de décodage, ce qui apparaît dans le plan d'exécution sous la forme 0 mod N, 1 mod N. N n'est exposé par aucun flag Thanos, il sort du runtime :
decodingConcurrency := opts.DecodingConcurrency
if opts.DecodingConcurrency < 1 {
    decodingConcurrency = max(runtime.GOMAXPROCS(0)/2, 1)
}
Depuis Go 1.25 le runtime lit la limite CPU du cgroup pour fixer GOMAXPROCS. Le seul composant de la stack qui porte une limite CPU est donc le seul dont le parallélisme de requête est plafonné et chez nous c'était le querier global, celui qui fusionne toutes les branches : il décodait sur 4 shards là où chacune de ses feuilles en utilisait 8. Personne n'a pris cette décision, elle est tombée d'un commit qui montait les requests et limits mémoire et qui a emmené le CPU avec lui.
L'autre moitié est pire : les composants sans limite CPU prennent le nombre de cœurs du nœud. Le parallélisme des requêtes est alors dicté par le gabarit que l'autoscaler a choisi ce matin-là, il change sans commit et sans que rien ne le signale.
Avant de corriger quoi que ce soit, la case Analyze de l'UI Thanos affiche le temps passé dans chaque nœud du plan d'exécution. Sur la requête qui nous intriguait, 1,88 s au total dont 1,38 s dans le sélecteur feuille et les 4 shards rendaient la même durée à la milliseconde près : ils finissaient ensemble parce qu'ils attendaient tous la même chose, les stores. Le décodage n'était pas le goulot, le CPU des pods plafonnait à 0,3 cœur sur une limite de 8 et doubler le nombre de shards n'aurait rien acheté.
Poser GOMAXPROCS explicitement reste utile pour que le comportement cesse de dépendre du nœud, mais tant que les requêtes attendent le réseau c'est de l'hygiène et pas une optimisation. Autant le savoir avant d'ouvrir le ticket.
Right-sizer le CPU d'un composant memory-bound ne rend rien
Le querier global demandait 4 cœurs pour un pic mesuré à 0,31, ce qui ressemble à une économie facile. Sur un gabarit highmem à environ 7,8 Gio par vCPU, ses 45 Go de RAM immobilisent déjà l'équivalent de 5,3 vCPU : descendre la request CPU ne libère aucun nœud et ne change même pas la densité de pods. C'est la dimension contraignante qui décide et ici c'est la mémoire.
Nos tests et nos échecs
Le PVC de la store gateway réglait le problème de disque saturé, mais pas la lenteur du téléchargement lui-même. L'étape suivante paraissait donc évidente : activer la stratégie de téléchargement paresseux, pour ne charger que ce dont on a besoin. Moins de disque, moins de trafic, un démarrage plus rapide.
On l'a retirée. Sur des dashboards historiques larges, ceux qui balaient plusieurs mois d'un coup, le p99 est monté jusqu'à environ 224 secondes. L'économie de disque ne valait pas des dashboards inutilisables.
Ce qui reste activé, c'est uniquement la lecture paresseuse en mémoire :
Toutes les optimisations de coût ne passent pas. Celle-là s'est payée en latence et on est revenus en arrière.
Le p99 est aveugle aux pathologies rares
Nos requêtes pathologiques représentaient 0,12 % du trafic. Un p99 se calcule sur les 99 % les plus rapides : il ne peut structurellement pas les voir. On lisait 0,15 s au p99 là où le p999 donnait 4 s et le p9999 5,3 s, soit un facteur 30 caché juste sous le seuil.
Ça marche dans les 2 sens. Sur un gate de concurrence, le p99 et le p999 donnaient tous les 2 10 à 17 ms, ce qui n'apprend rien : c'est le p9999 à 95 ms qui a permis d'écarter la mise en file avec certitude, pics de saturation compris.
Dès qu'une pathologie touche nettement moins de 1 % des requêtes, mesurer au p999 ou au p9999, ou ne pas mesurer du tout. On a tiré 2 conclusions fausses avant de s'en apercevoir.
Lecture paresseuse : le prix du rechargement
Ce flag n'est pas une optimisation qu'on serait allés chercher, c'est la contrepartie du spot. Une store gateway évictée doit récupérer ses index-headers avant de pouvoir répondre, et sur des instances économiques qui sont IO bound ça se compte en dizaines de minutes, les mêmes que celles de la reprise après éviction plus haut. La lecture paresseuse raccourcit ce démarrage, donc on la garde. Ce qu'on n'avait jamais fait, c'est mesurer ce qu'elle déplace.
Le flag décharge un index-header après un délai d'inactivité qui vaut 5 minutes par défaut. Sur une plateforme où les dashboards ne sont ouverts que par intermittence, les headers ne sont donc presque jamais résidents : sur le shard qui porte les blocks les plus vieux, la résidence tourne entre 0 et 9 % sur toute la flotte et le shard chaud décharge entre 18 et 32 fois par heure et par pod. Le premier utilisateur qui ouvre un dashboard paie un rechargement complet avant qu'une seule série ne soit lue, ce qui est exactement le symptôme « la première requête est interminable » qu'on nous remontait sans savoir quoi en faire.
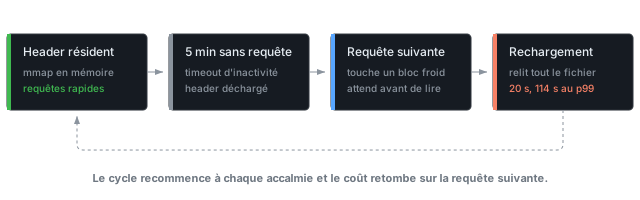
Le coût de ce rechargement n'a rien à voir avec le flag, il est fixé par la taille du fichier d'index-header, elle-même fixée par la cardinalité du tenant. Le plus lourd de nos tenants porte 2,1 Go par header contre 0,12 Go pour le plus léger, un facteur 17, et le classement des durées de chargement suit exactement : 20 secondes de moyenne et 114 s au p99 d'un côté, moins de 0,5 s de l'autre.
Ce n'est ni du CPU ni du disque saturé, on a vérifié les 2 avant de conclure : pendant un chargement de 28 secondes le conteneur consommait 0,04 cœur et les disques tournaient à moins de la moitié de leur temps d'occupation. C'est un gros fichier qu'on relit, rien de plus.
Aucun flag ne règle ça. Monter le délai d'inactivité déplace le problème sans le supprimer, puisqu'un pod qui redémarre repart avec zéro header chargé et charger tout au démarrage revient à provisionner la RAM pour l'intégralité du corpus d'index-header.
Le flag ne supprime donc pas le coût, il le déplace du démarrage vers la première requête. Tant que les évictions spot sont fréquentes et le disque lent, c'est le bon arbitrage : 30 secondes sur un dashboard valent mieux qu'une store gateway absente une demi-heure. Il cesse de l'être le jour où la cardinalité rend le rechargement plus cher que le démarrage qu'il évite, et sur notre plus gros tenant ce jour est arrivé. C'est un choix contraint par le gabarit d'instance, pas un réglage de performance, et le vrai levier est une couche plus bas : des disques plus rapides ou moins de séries.
Les métriques que personne n'affiche
Aucun dashboard livré ne porte ces compteurs, alors qu'ils sont exposés par défaut. Tant qu'on ne les trace pas, le symptôme reste invisible et il faut passer les logs de la store gateway en debug pour voir passer les lazy loaded index-header.
| métrique | ce qu'elle dit |
|---|---|
thanos_bucket_store_indexheader_lazy_load_total | chargements |
thanos_bucket_store_indexheader_lazy_unload_total | évictions après le délai d'inactivité |
thanos_bucket_store_indexheader_lazy_load_duration_seconds | le prix d'un chargement |
thanos_bucket_store_indexheader_lazy_load_failed_total | un header perdu, donc des résultats incomplets en silence |
Le panel qui manquait le plus est la résidence, (load - unload) / blocks_loaded, qui dit d'un coup d'œil quelle part du corpus est encore chargée. À 0, la prochaine requête paiera plein tarif.
Ne pas passer histogram_quantile sur cet histogramme
Ses bornes de buckets sautent 5, 15, 30, 60, 90, 120 puis 300 secondes, donc tout quantile qui tombe au-delà de 5 s est interpolé dans un bucket large de dizaines de secondes et sort une courbe lisse qui est un artefact. On lit la moyenne par sum / count, qui est exacte, et on compte les franchissements de bucket pour la queue.
Réplication : le choix assumé
Thanos Receive sait faire du hashring et de la réplication. L'infrastructure est déployée, le receive-controller tourne, la ConfigMap de hashring existe, le flag est câblé.
Il n'est activé nulle part. Le facteur de réplication réel est de 1.
La résilience ne repose donc pas sur la duplication de l'ingestion, mais sur 2 autres choses : la rétention locale de la TSDB (12 heures de head) et l'upload continu vers l'object storage. Si un receive tombe, on perd la fenêtre non uploadée de ce tenant, pas l'historique.
C'est un arbitrage coût contre disponibilité, pas un oubli. Un facteur de réplication supérieur à 1 multiplie la mémoire, puisque chaque replica maintient sa propre copie des séries en RAM et on parle du composant qui est justement en on-demand. Le flag reste prêt pour basculer un tenant précis si son SLA le justifie.
Le raisonnement se retourne d'ailleurs, parce qu'avec RF=2 et au moins 2 replicas une éviction devient survivable, donc receive pourrait descendre sur spot comme le reste et on récupérerait l'économie sur le composant le plus cher. Ce qu'on paierait à la place, c'est une archi nettement plus complexe, avec le hashring à maintenir, le receive-controller qui le recalcule à chaque changement de topologie et les rééquilibrages qui vont avec. On a préféré payer de l'on-demand plutôt que de la complexité.
À ne pas confondre avec la déduplication
Le --deduplication.replica-label=prom_replica vu plus haut n'a rien à voir. Il traite les paires de Prometheus en HA qui écrivent les mêmes séries en double vers Receive. La réplication interne de Receive, elle, est bien désactivée.
Garder une vingtaine de stacks maintenables
Une stack par cluster, ça veut dire dupliquer la configuration autant de fois. La réponse tient en 2 mécanismes.
Un ApplicationSet ArgoCD génère les stacks à partir d'un sélecteur de labels sur le registre de clusters. Ajouter un cluster à la flotte ne demande aucune merge request sur Thanos : on pose le label sur le cluster, la stack apparaît.
Les values Helm sont empilées en couches, de la plus générique à la plus spécifique :
values/common/            defaults partagés par toutes les stacks
values/thanos-common/     defaults de l'archétype « stack régional »
values/thanos-<type>/     surcharge par type de bucket
values/thanos-<tenant>/   surcharge dédiée à un tenant
L'option qui rend le tout praticable est ignoreMissingValueFiles: true : chaque étage devient optionnel. On déclare les 4 couches partout et seules celles qui existent s'appliquent.
Les versions récentes d'ArgoCD acceptent le glob dans valueFiles. Une couche découpée en 12 fichiers par composant tient alors en 1 ligne au lieu de 12 :
helm:
  ignoreMissingValueFiles: true
  valueFiles:
    - $argocd/apps/thanos/values/common/*.yml
    - $argocd/apps/thanos/values/thanos-common/*.yml
Le glob s'expanse alphabétiquement
Sans conséquence à l'intérieur d'une couche quand les fichiers sont découpés par composant et ne se recouvrent pas, mais on garde un wildcard par couche et les couches restent ordonnées : c'est entre elles que la précédence compte, pas dedans.
Voir aussi
- Les caches Thanos - mutualiser les 3 caches sur un backend partagé, et ce que ça change sur la facture
- Grafana Alloy - la collecte en amont, le
remote_writepointe vers Receive au lieu de Mimir - GKE Spot Nodes - la même ligne de partage entre workloads évictables et critiques
- Netdata, Prometheus et Grafana - la stack de départ, avant que la rétention devienne un problème